Цифры говорят

При ручной обработке инцидента, чтобы удостовериться в том, что отказ действительно произошёл и виртуальные машины необходимо восстановить, инженеру приходится сопоставлять данные из нескольких источников. После подтверждения отказа инженеру необходимо изолировать отказавший гипервизор и найти новый, подходящий по параметрам и наличию свободных ресурсов. И только после этого начинать процесс эвакуации виртуальных машин. Все это увеличивает временной интервал между обнаружением сбоя и восстановлением сервиса для конечных пользователей.
HA-режим сервиса KeyVRM полностью автоматизирует упомянутые действия, действуя как бесконечный цикл проверок и принятия решений.
В начале каждого цикла KeyVRM собирает согласованный снимок состояния региона. Из OpenStack сервис получает сведения о гипервизорах, вычислительных сервисах, виртуальных машинах и ресурсах. Из системы мониторинга heartbeat - вычислительных узлов и данные о состоянии сервисов и аппаратных частей гипервизоров. Все события коррелируются и сохраняются в базе данных истории, чтобы при разборе инцидента и составлении RCA можно было восстановить весь ход обработки.
HA-режим KeyVRM сначала подтверждает отказ и изолирует гипервизор. Рекомендации по эвакуации создаются после успешной изоляции и только при наличии подходящего целевого узла.
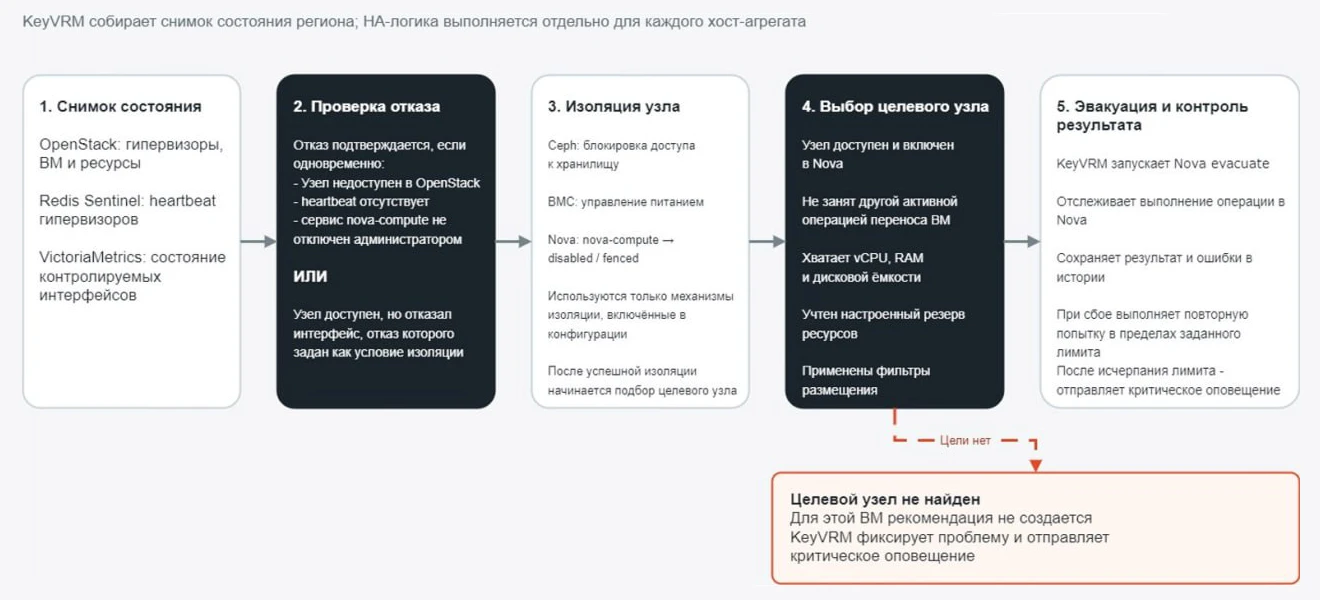
KeyVRM собирает снимок состояния региона, HA-логика выполняется отдельно для каждого хост-агрегата
Источник: ITKey
В KeyStack режим HA настраивается отдельно для каждого хост-агрегата OpenStack.
В основном сценарии гипервизор считается отказавшим при одновременном выполнении двух условий:
Есть и второй сценарий: узел остаётся доступным в OpenStack, но мониторинг фиксирует отказ сетевого интерфейса или HBA, отказ которого в конфигурации KeyVRM указан как условие изоляции узла.
KeyVRM различает интерфейсы, отказ которых является причиной к изоляции, и интерфейсы, состояние которых сервис только контролирует. Поэтому не каждый отказ интерфейса приводит к изоляции узла и последующей эвакуации ВМ.
После подтверждения отказа KeyVRM выполняет fencing-изоляцию отказавшего гипервизора перед эвакуацией ВМ. Для этого сервис последовательно применяет включённые в конфигурации механизмы: сначала ограничивает доступ узла к SDS (если SDS используется в платформе), затем изолирует его на логическом уровне в OpenStack и, при необходимости, управляет его питанием через BMC.
В SDS доступ блокируется для IP отказавшего узла. Через BMC выполняется настроенная команда управления питанием по IPMI или Redfish, а в OpenStack nova-compute переводится в состояние disabled и помечается как fenced; при необходимости для него также устанавливается forced down. При этом disabled означает исключение гипервизора из размещения новых ВМ, а не остановку самого процесса nova-compute. Рекомендации по эвакуации создаются только для успешно изолированных гипервизоров.
При многократном сбое, если изоляция части узлов завершилась ошибкой, KeyVRM отправляет критическое оповещение и продолжает обработку успешно изолированных гипервизоров. Если изолировать не удалось ни одного узла, событие завершается с ошибкой без рекомендаций по эвакуации.
В штатном HA-сценарии отдельное подтверждение оператора не требуется. После формирования рекомендации на эвакуацию ВМ KeyVRM запускает компонент Executor, который, управляя сервисом Nova, запускает операции evacuate и отслеживает состояние каждой такой операции.
Минимальный настраиваемый период запуска основного цикла KeyVRM - 30 секунд. Это не время восстановления ВМ, но это время реакции на сбой в инфраструктуре.
Для каждой ВМ KeyVRM определяет подходящие целевые гипервизоры. Из рассмотрения исключаются отказавшие узлы и гипервизоры, уже выбранные целью другой активной операции переноса ВМ. Оставшиеся гипервизоры должны быть доступны в OpenStack, а их сервис nova-compute - включён и находиться в активном административном состоянии. Затем KeyVRM проверяет, достаточно ли на каждом узле vCPU, RAM и дисковой ёмкости, с учётом резерва ресурсов, заданного для хост-агрегата.
Дополнительные ограничения задаются фильтрами размещения, включёнными в конфигурации KeyVRM. Например, фильтры affinity и anti-affinity позволяют учитывать правила совместного и раздельного размещения ВМ, заданные в серверных группах OpenStack. Метаданные ВМ позволяют исключить отдельные машины из автоматической эвакуации и задать порядок её выполнения, например, сначала обработать инфраструктурные ВМ, а затем прикладные.
Если для ВМ найден подходящий целевой гипервизор, KeyVRM создаёт рекомендацию на эвакуацию. Executor запускает Nova evacuate, отслеживает статус операции и сохраняет ход её выполнения в истории.
Если подходящий целевой гипервизор не найден, рекомендация для этой ВМ не создаётся, а KeyVRM отправляет критическое оповещение.
Ошибки возможны и после запуска процесса эвакуации. При сбоях сетевой привязки (port binding) или подключения тома (volume attachment) Executor проверяет привязки портов Neutron и при необходимости восстанавливает активную привязку к исходному гипервизору. Если ошибка связана с подключением тома, KeyVRM дополнительно удаляет зависшие подключения Cinder. После такой очистки Executor может повторить выполнение рекомендации, если ошибка допускает повтор и установленные лимиты ещё не исчерпаны.
В конфигурации задаются общий лимит попыток выполнения рекомендации и отдельный предел повторения одной и той же ошибки. Если одинаковая ошибка повторяется установленное число раз, KeyVRM прекращает дальнейшие попытки по этой рекомендации, помечает её как завершившуюся с ошибкой и отправляет критическое оповещение, даже если общий лимит попыток ещё не исчерпан.
Если первая попытка разгрузить отказавший гипервизор завершилась не полностью, KeyVRM заново подбирает целевые узлы для оставшихся ВМ и формирует новые рекомендации на эвакуацию. Всего сервис выполняет не более двух попыток разгрузки исходного гипервизора. Если после второй попытки на нём всё ещё остаются ВМ, KeyVRM переводит гипервизор в состояние ошибки и отправляет запрос на остановку оставшихся ВМ.
Время восстановления зависит от характера отказа, используемых механизмов изоляции, состояния инфраструктуры и наличия подходящего целевого гипервизора. KeyVRM сохраняет историю обработки инцидента в виде событий, рекомендаций и операций. По сохранённой истории инженеры эксплуатации могут определить, какие действия KeyVRM запланировал и выполнил, где потребовалась повторная попытка и на каком этапе произошёл сбой.